الرئيسية / البيانات / استخراج البيانات
بناء Big Data Pipeline آلي باستخدام PySpark وAirflow وDocker
وصف الخدمة
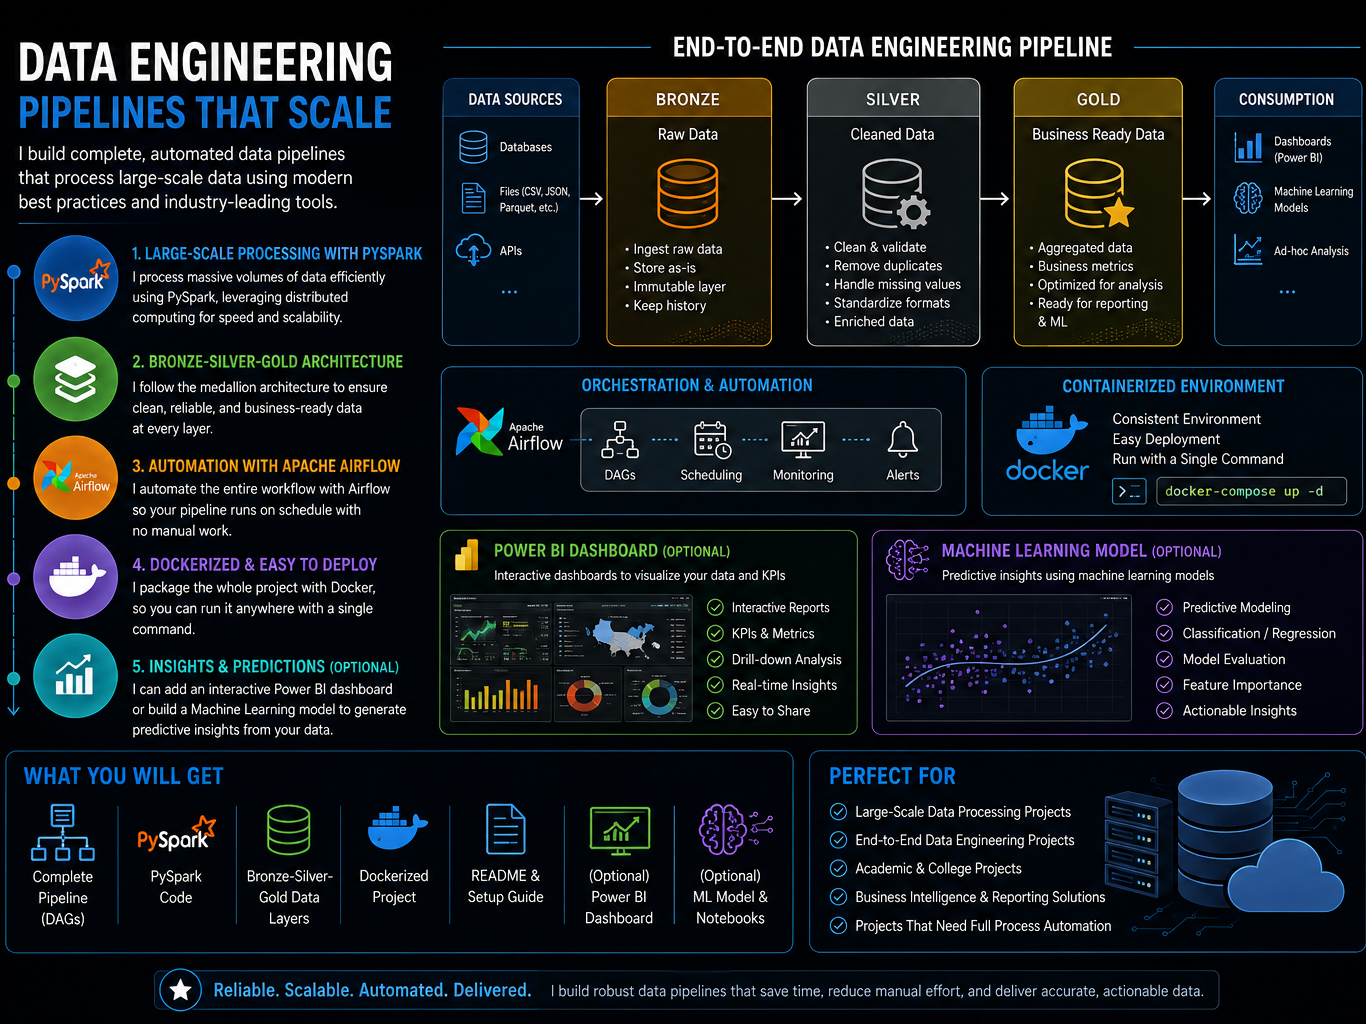
بعمل لك Pipeline بيعالج بيانات كبيرة باستخدام PySpark، وبخليه يشتغل تلقائي كل فترة باستخدام Airflow من غير ما تتدخل يدويًا:
✅ معالجة البيانات الضخمة بمعمارية Bronze-Silver-Gold (PySpark)
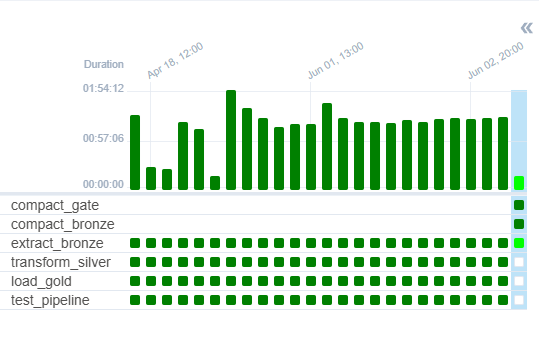
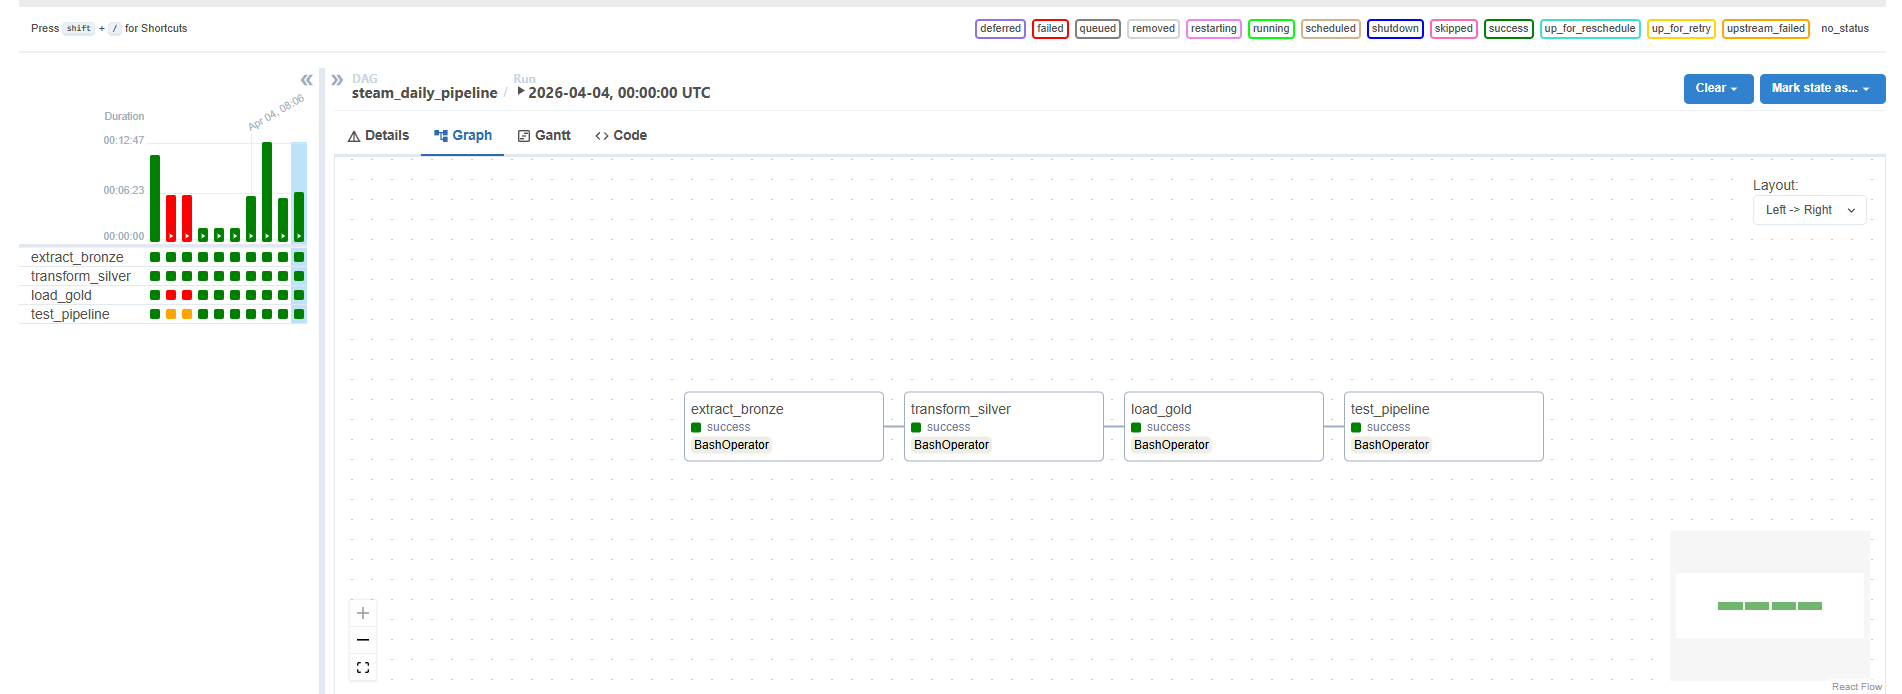
✅ جدولة وتشغيل تلقائي للـ Pipeline (Apache Airflow)
✅ تغليف المشروع بالكامل باستخدام Docker عشان يشتغل بأمر واحد
لو حابب، أقدر أضيفلك:
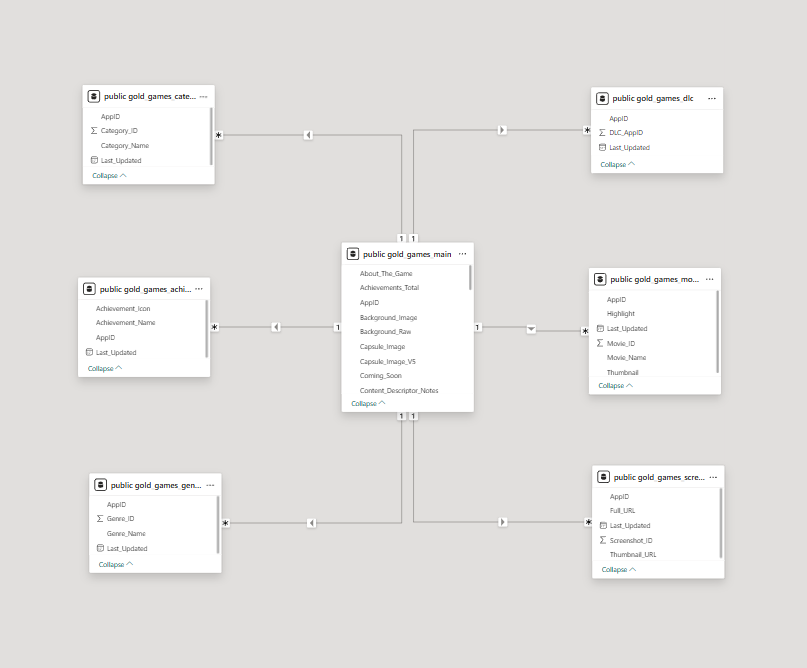
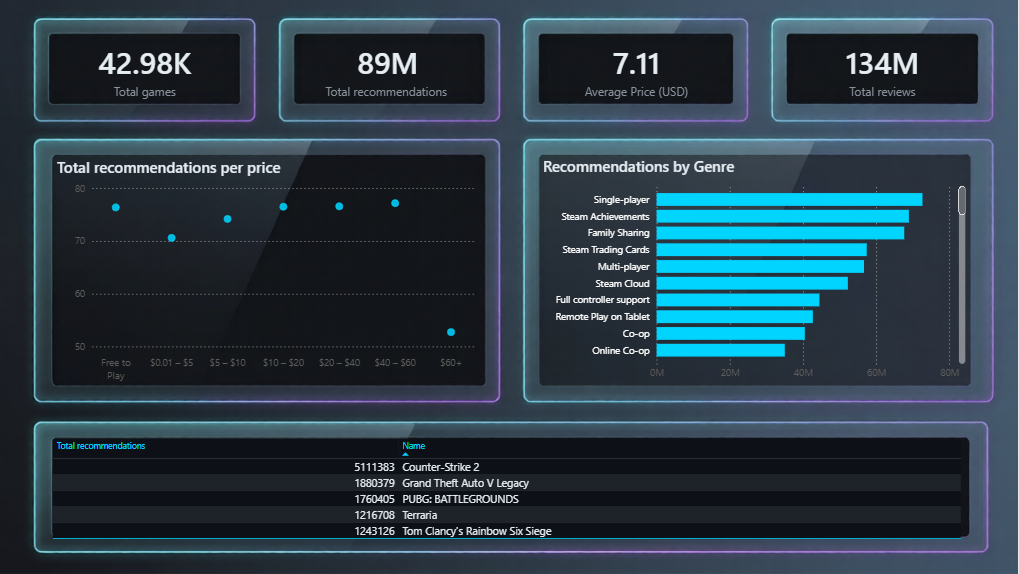
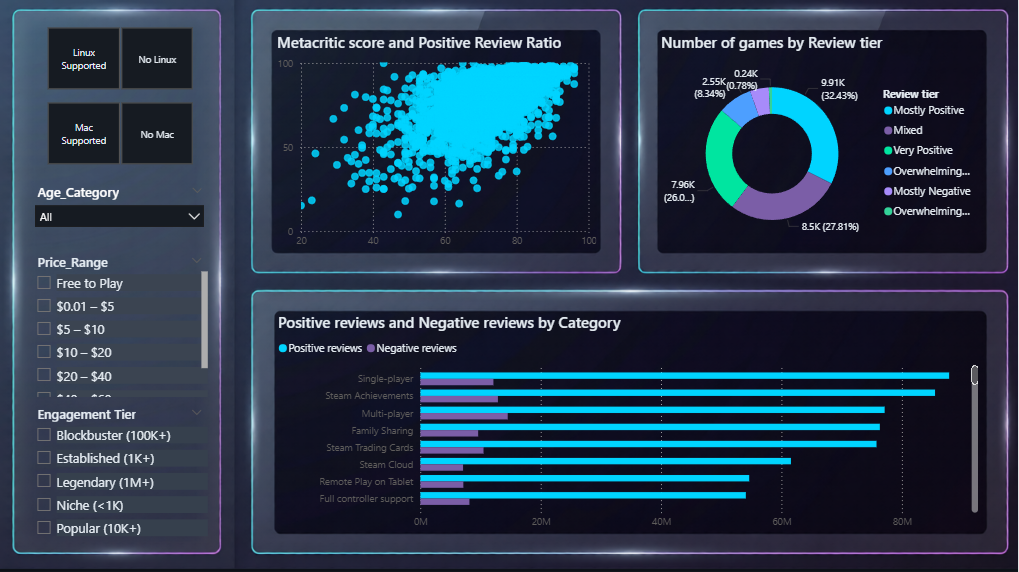
🎯 Dashboard تفاعلي بـ Power BI لعرض النتائج بصريًا
🎯 نموذج Machine Learning بسيط يطلعلك توقعات من البيانات
هتستلم:
Pipeline كامل لمعالجة البيانات (PySpark)
إعداد Airflow لتشغيل الـ Pipeline تلقائيًا
إعداد Docker لتشغيل المشروع بأمر واحد
Power BI Dashboard (اختياري)
نموذج Machine Learning مع شرح النتائج (اختياري)
تعليمات للمشتري
لتقديم خدمة أفضل وأسرع، من فضلك أرفق:
عينة من البيانات أو مصدرها (API، ملف، قاعدة بيانات)
وصف مختصر لحجم البيانات وهدف المشروع
هل محتاج الـ Pipeline يشتغل مرة واحدة ولا بشكل دوري (يومي/ساعة)
شراء الخدمة
سعر الخدمة :
84.52
الخدمات الإضافية
Power BI Dashboard
60.38
يومان
 أضف إلى السلة (84.52 )
مقدم الخدمة
Mohamed A.
عدد المشاريع0 مشروعاً
إكمال المشاريع 0%
عدد التقييمات
(0)
آخر تواجد
منذ شهر
تفاصيل الخدمة
تاريخ الإضافة
29 أغسطس 2026
موقع الخدمة
مصر، القاهرة
مستوى اللغة الإنجليزية
متقدم
عدد الساعات
16
مدة التسليم
ستة أيام
عدد مرات التعديل
3
عدد التقييمات
(0)